- Solution Architecture
- solution-design
- aws
- cloud-native-geospatial
- postgis
Merancang Sistem Deteksi Kebakaran Gambut untuk Kalimantan Tengah dengan AWS dan GIS Open-Source
Rancangan end-to-end deteksi kebakaran gambut di Kalimantan Tengah dengan data satelit gratis, GIS open-source, dan AWS, serta alasan tiap komponennya.
Masalah apa yang diselesaikan sistem ini?
Sistem ini mengubah data api dari satelit gratis menjadi tugas lapangan yang datang cukup cepat untuk berguna, sekaligus menyimpan riwayat area yang terbakar. Ini latihan desain untuk instansi provinsi fiktif di Kalimantan Tengah, dibangun hanya dengan data publik, GIS open-source, dan AWS. Tidak ada klien nyata, tidak ada anggaran nyata.
Titik awal yang saya asumsikan umum di operasi kebencanaan: petugas memantau peta titik panas secara manual, memutuskan ke mana regu pemadam dikirim berdasarkan pengalaman, dan memetakan area terbakar setelah musim kebakaran, itu pun kalau sempat. Ada tiga hal yang hilang:
- Kecepatan dan konsistensi. Titik panas ditangani atau tidak tergantung siapa yang sedang bertugas.
- Prioritas. Regu pemadam sedikit, titik panas banyak, dan tidak ada yang mengurutkannya.
- Ingatan. Deteksi, hasil cek lapangan, dan area terbakar tidak tersimpan di satu tempat, jadi musim berikutnya mulai dari nol.
Sistem ini punya tiga jenis pengguna: ruang operasi yang memilah peringatan, tim lapangan yang mengecek dan melapor, dan pimpinan yang butuh gambaran mingguan per kabupaten.
Kenapa Kalimantan Tengah?
Karena kebakarannya sebagian besar kebakaran gambut, yang sulit dipadamkan begitu meluas. Pada 1990-an, Proyek Lahan Gambut Sejuta Hektare menggali lebih dari 4.500 km kanal untuk mengeringkan gambut demi rencana sawah sejuta hektare. Gambut yang sudah kering tetap kering dan mudah terbakar. Pada 2019, api membakar hampir 270.000 hektare lahan di provinsi ini, sebagian besar di bekas area proyek tersebut.
Api gambut membara di bawah permukaan dan bisa bertahan berminggu-minggu. Itu yang membentuk seluruh desain: nilai sistem ini ada di jam-jam pertama, sebelum api permukaan berubah menjadi api gambut.
Apa yang harus dilakukan sistem ini?
Lima fungsi, ditambah beberapa kualitas yang berlaku untuk semuanya.
| Kebutuhan | Yang dilakukan sistem |
|---|---|
| Peringatan dini | Menarik titik panas baru beberapa kali sehari dan mengubahnya menjadi cluster api yang diurutkan |
| Prioritas | Memberi skor tiap cluster dengan aturan yang transparan dan membatasi daftar harian sesuai kapasitas regu |
| Validasi lapangan | Mengirim tugas ke aplikasi mobile yang bisa offline, dengan foto, GPS, dan formulir singkat |
| Area terbakar | Memetakan area terbakar dari citra optik setelah kejadian dan menyimpannya sebagai poligon |
| Pelaporan | Dashboard per kabupaten, status gambut, dan periode, plus status run pipeline terakhir |
| Kualitas | Aturan desain |
|---|---|
| Auditability | Perubahan status ditambahkan, tidak pernah ditimpa; setiap poligon mencatat citra sumber dan parameternya |
| Reliability | Run yang gagal diulang dan terlihat di dashboard; run yang terlewat tidak boleh tampak seperti "tidak ada api" |
| Keamanan | Akses berbasis peran; data lapangan dan catatan internal tidak publik |
| Interoperabilitas | Instansi lain membaca data lewat standar terbuka (layanan OGC), bukan file kiriman lewat email |
| Biaya | Bayar compute saat pipeline berjalan; tanpa lisensi software |
Asumsi yang saya nyatakan: kapasitas lapangan adalah sumber daya paling langka, koneksi di lapangan tidak bisa diandalkan, dan instansi lebih memilih data disimpan di Indonesia.
Kenapa dua pipeline dengan dua ritme?
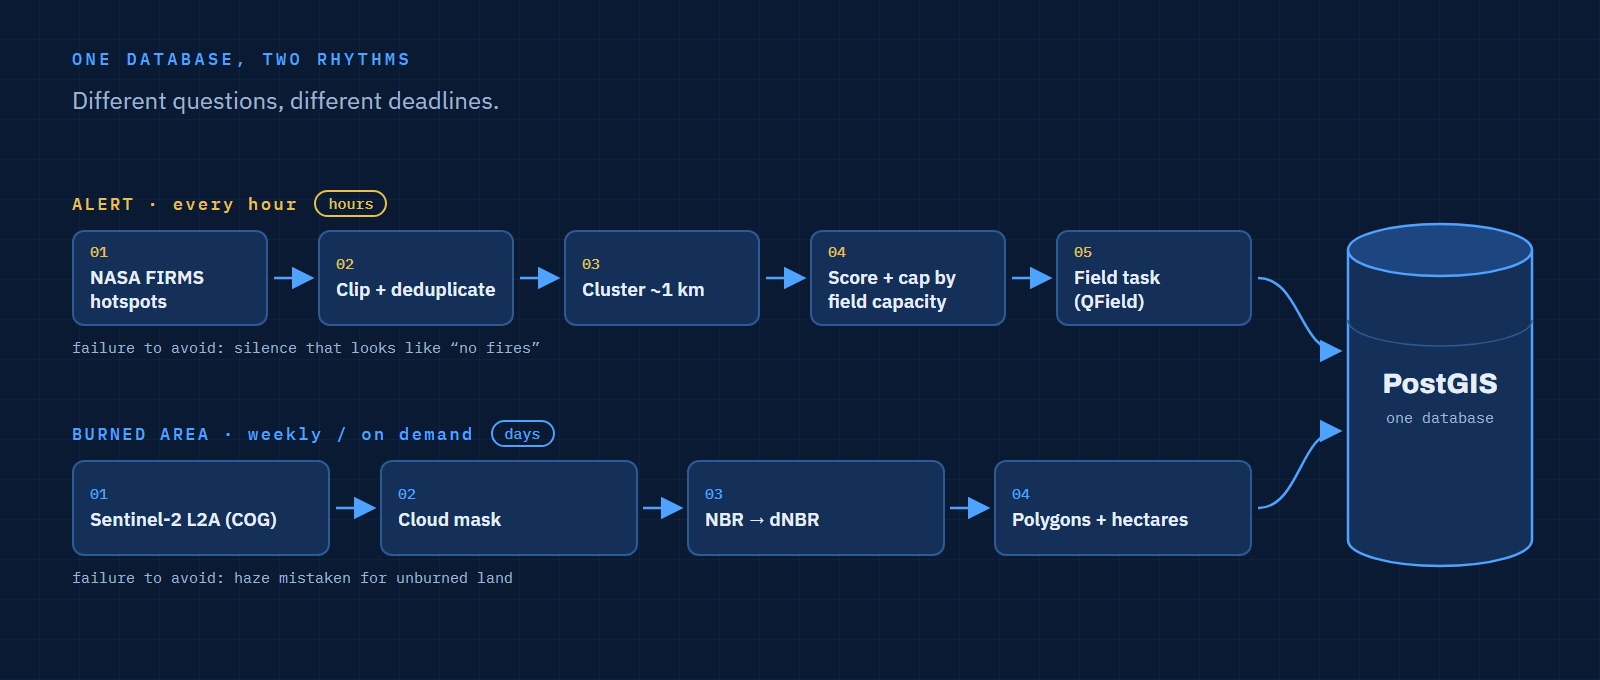
Karena kebakaran punya dua pertanyaan dengan tenggat yang sangat berbeda. "Di mana yang sedang terbakar?" butuh jawaban dalam hitungan jam. "Apa yang terbakar, dan seluas apa?" bisa menunggu citra satelit yang cerah beberapa hari kemudian. Memaksa keduanya ke satu jadwal membuat salah satunya keliru: peringatan jadi terlalu lambat, atau job pemetaan berjalan sia-sia di atas citra berawan.
| Pipeline peringatan | Pipeline area terbakar | |
|---|---|---|
| Pertanyaan | Di mana yang sedang terbakar? | Apa yang terbakar, dan seluas apa? |
| Data | Titik panas NASA FIRMS (VIIRS dan MODIS) | Copernicus Sentinel-2 L2A |
| Pemicu | Terjadwal, setiap jam | Terjadwal mingguan, dan sesuai permintaan setelah kejadian |
| Output | Cluster api yang diurutkan dan tugas lapangan | Poligon area terbakar dengan luas dalam hektare |
| Compute | Detik, tabel kecil | Menit, raster besar |
| Kegagalan yang harus dihindari | Sunyi yang tampak seperti "tidak ada api" | Awan dan asap dikira lahan yang tidak terbakar |
 Buka ukuran penuh
FIRMS menerbitkan data api aktif global dalam tiga jam setelah satelit melintas. Dengan menarik data setiap jam, deteksi baru paling lama menunggu satu jam di sisi kita, sehingga keterlambatan dari sisi instansi tetap lebih kecil daripada keterlambatan dari satelitnya.
Seperti apa arsitekturnya dari ujung ke ujung?
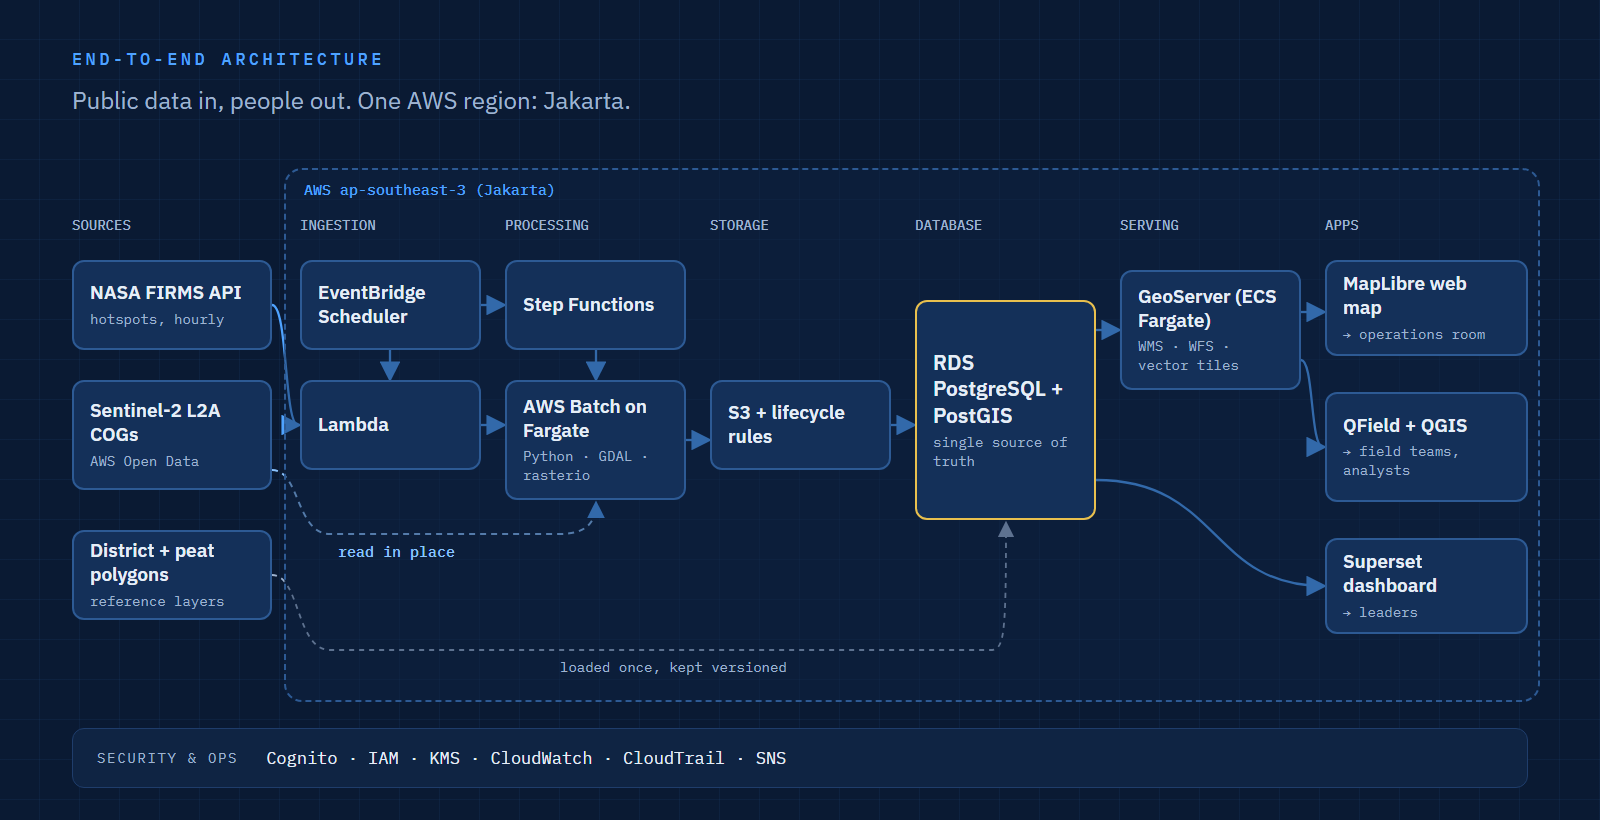
Tujuh lapisan, dari sumber data publik sampai orang yang bertindak atas datanya. Semua berjalan di satu region AWS, Asia Pacific (Jakarta), kecuali arsip citra terbuka, yang dibaca langsung oleh pipeline di tempatnya.
 Buka ukuran penuh
| Lapisan | Komponen | Peran |
|---|---|---|
| Sumber | NASA FIRMS API, COG Sentinel-2 L2A di AWS Registry of Open Data, poligon batas kabupaten dan gambut | Input gratis |
| Ingestion | Amazon EventBridge Scheduler, AWS Lambda | Menarik titik panas baru setiap jam |
| Pemrosesan | AWS Step Functions, AWS Batch di Fargate (Python, GDAL, rasterio) | Mengelompokkan dan memberi skor titik panas; menghitung area terbakar |
| Penyimpanan | Amazon S3 dengan lifecycle rule | Citra hasil potong, output, log run |
| Database | Amazon RDS for PostgreSQL dengan PostGIS | Cluster, poligon, tugas, riwayat status |
| Penyajian | GeoServer di Amazon ECS (Fargate) | WMS, WFS, dan vector tile untuk semua klien |
| Aplikasi | Peta web MapLibre, dashboard Apache Superset, QField dan QGIS | Ruang operasi, pimpinan, tim lapangan, analis |
| Lintas lapisan | Amazon Cognito, IAM, KMS, CloudWatch, CloudTrail, Amazon SNS | Akses, enkripsi, monitoring, audit, notifikasi |
Kenapa memilih tech stack ini?
Setiap pilihan menjawab satu kebutuhan, dan setiap pilihan punya alternatif yang akan saya pakai kalau kendalanya berbeda.
| Komponen | Kenapa yang ini | Kapan saya memilih yang lain |
|---|---|---|
| NASA FIRMS | Gratis, global, tersedia dalam tiga jam, dengan API sederhana; VIIRS mendeteksi pada resolusi 375 m | Untuk peringatan dalam hitungan menit, tambahkan data geostasioner (lihat bagian terakhir) |
| Sentinel-2 L2A | Gratis dan terbuka, resolusi 10–20 m, sudah terkoreksi atmosfer, dan tersimpan di AWS sebagai Cloud-Optimized GeoTIFF dengan API pencarian STAC | Radar Sentinel-1 kalau asap dan awan menutup citra optik berminggu-minggu |
| EventBridge Scheduler + Lambda | Panggilan tiap jam yang mengembalikan CSV kecil tidak layak dibuatkan server yang menyala terus; biayanya nyaris nol saat diam | Container kalau job-nya tumbuh melewati batas 15 menit Lambda |
| Step Functions + AWS Batch | Job raster butuh GDAL, memori, dan waktu jalan beberapa menit, cocok untuk container. Step Functions menambahkan retry dan riwayat run yang terlihat, yang mengisi panel "run terakhir" di dashboard | Airflow atau Kestra kalau instansi sudah menjalankannya untuk pipeline lain; untuk dua pipeline, server scheduler adalah beban tambahan |
| S3 + pembacaan COG | Pipeline hanya membaca piksel di dalam provinsi dari arsip terbuka, bukan menyalin seluruh scene; lifecycle rule menghapus citra setelah masa retensinya | Tidak ada di skala ini |
| PostgreSQL + PostGIS | Pertanyaan intinya adalah spatial join dan clustering (kabupaten mana, di gambut atau bukan, titik panas mana yang satu kelompok), dan PostGIS mengerjakannya dalam SQL. Analis membuka tabel yang sama langsung di QGIS | Data warehouse seperti Athena atau Redshift hanya kalau riwayat bertahun-tahun membuat query analitik lambat |
| GeoServer | Satu server menerbitkan layer yang sama sebagai layanan OGC untuk QGIS, QField, peta web, dan instansi lain | Tile server yang lebih ringan (Martin, pg_tileserv) kalau peta web satu-satunya klien |
| MapLibre GL JS | Peta web open-source yang merender vector tile, di-hosting sebagai file statis di S3 dan CloudFront | Tidak perlu |
| Apache Superset | Filter, grafik, dan peta di atas PostGIS tanpa menulis front end, dengan akses berbasis peran | Halaman custom kalau pimpinan hanya butuh tiga angka |
| QField + QGIS | QField menjalankan project QGIS di ponsel, bisa offline, lalu sinkron kembali; formulir dan style cukup dibuat sekali di QGIS | ODK atau KoboToolbox kalau formulir lebih penting daripada peta |
| Region Jakarta | Menjaga data instansi tetap di Indonesia | Arsip citra terbuka di-hosting di luar Indonesia; hanya hasil potongnya yang disimpan lokal |
Bagaimana titik panas menjadi tugas lapangan?
Dalam enam langkah, dan pengurutannya memakai aturan yang terlihat, bukan model kotak hitam.
- Tarik. Lambda memanggil API area FIRMS untuk bounding box provinsi dan memuat deteksi baru ke tabel staging.
- Potong dan buang duplikat. Simpan titik di dalam poligon provinsi; buang deteksi yang sudah dimuat di panggilan sebelumnya.
- Kelompokkan. Satukan deteksi yang berjarak sekitar 1 km satu sama lain dalam 24 jam terakhir menjadi satu cluster api.
- Perkaya. Tempelkan kabupaten, status gambut, dan tutupan lahan ke setiap cluster dengan spatial join.
- Beri skor dan batasi. Urutkan cluster dan simpan hanya sebanyak tugas "prioritas" yang bisa dicek tim lapangan hari itu.
- Tugaskan dan lacak. Buat tugas untuk QField, beri tahu petugas piket lewat SNS, dan tambahkan setiap perubahan status ke riwayat.
-- Step 3: cluster today's hotspots (UTM 50S, metres; ~1 km, at least 2 points)
SELECT id,
ST_ClusterDBSCAN(ST_Transform(geom, 32750), eps => 1000, minpoints => 2)
OVER () AS cluster_id
FROM hotspots
WHERE acq_time > now() - interval '24 hours';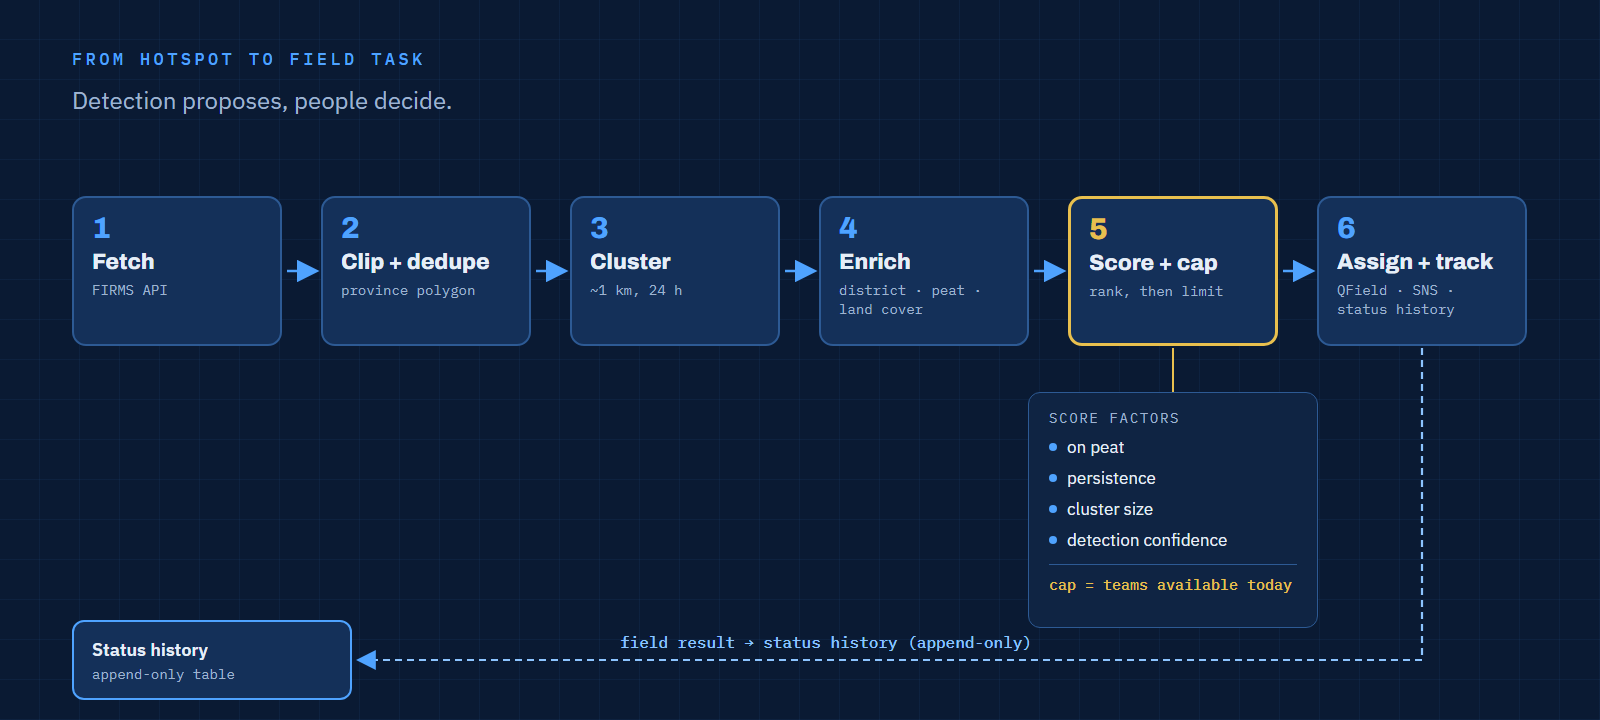 Buka ukuran penuh
| Faktor skor | Kenapa penting |
|---|---|
| Di atas gambut | Api gambut menjalar di bawah tanah dan paling sulit dihentikan |
| Persistensi | Terdeteksi lagi di lintasan berikutnya berarti masih menyala |
| Ukuran cluster | Lebih banyak deteksi biasanya berarti api lebih besar |
| Confidence deteksi | FIRMS menandai deteksi dengan confidence rendah |
Bagian terpentingnya adalah batasnya. Kalau setiap cluster di atas ambang tertentu dianggap "prioritas", hari yang buruk menghasilkan daftar yang tidak mungkin diselesaikan, dan labelnya kehilangan makna. Mengurutkan berdasarkan jumlah tim yang benar-benar tersedia menjaga bagian atas daftar tetap bisa dikerjakan. Setiap tugas menampilkan skor dan faktor pembentuknya, sehingga petugas piket bisa tidak setuju dengan alasan yang jelas.
Bagaimana area terbakar dipetakan?
Dengan selisih rasio bakar sebelum dan sesudah kebakaran, dihitung dari dua band Sentinel-2. Normalized Burn Ratio memakai near-infrared (B8A) dan shortwave infrared (B12); vegetasi yang terbakar menurunkan nilainya, sehingga penurunan besar antara citra sebelum dan sesudah kebakaran menandai lahan yang terbakar.
# Burned area candidate from two cloud-masked Sentinel-2 L2A images
nbr_pre  = (pre.B8A - pre.B12) / (pre.B8A + pre.B12)
nbr_post = (post.B8A - post.B12) / (post.B8A + post.B12)
dnbr = nbr_pre - nbr_post
burned = dnbr > 0.27          # starting threshold, tuned against field checks
Job batch kemudian menyaring awan dan bayangan dengan layer klasifikasi scene dari L2A, mengubah piksel terbakar menjadi poligon, membuang serpihan di bawah luas minimum, dan menghitung luas dalam hektare di PostGIS dengan ST_Area(geom::geography). Cara ini menghindari keharusan memilih satu zona UTM untuk provinsi yang membentang di dua zona.
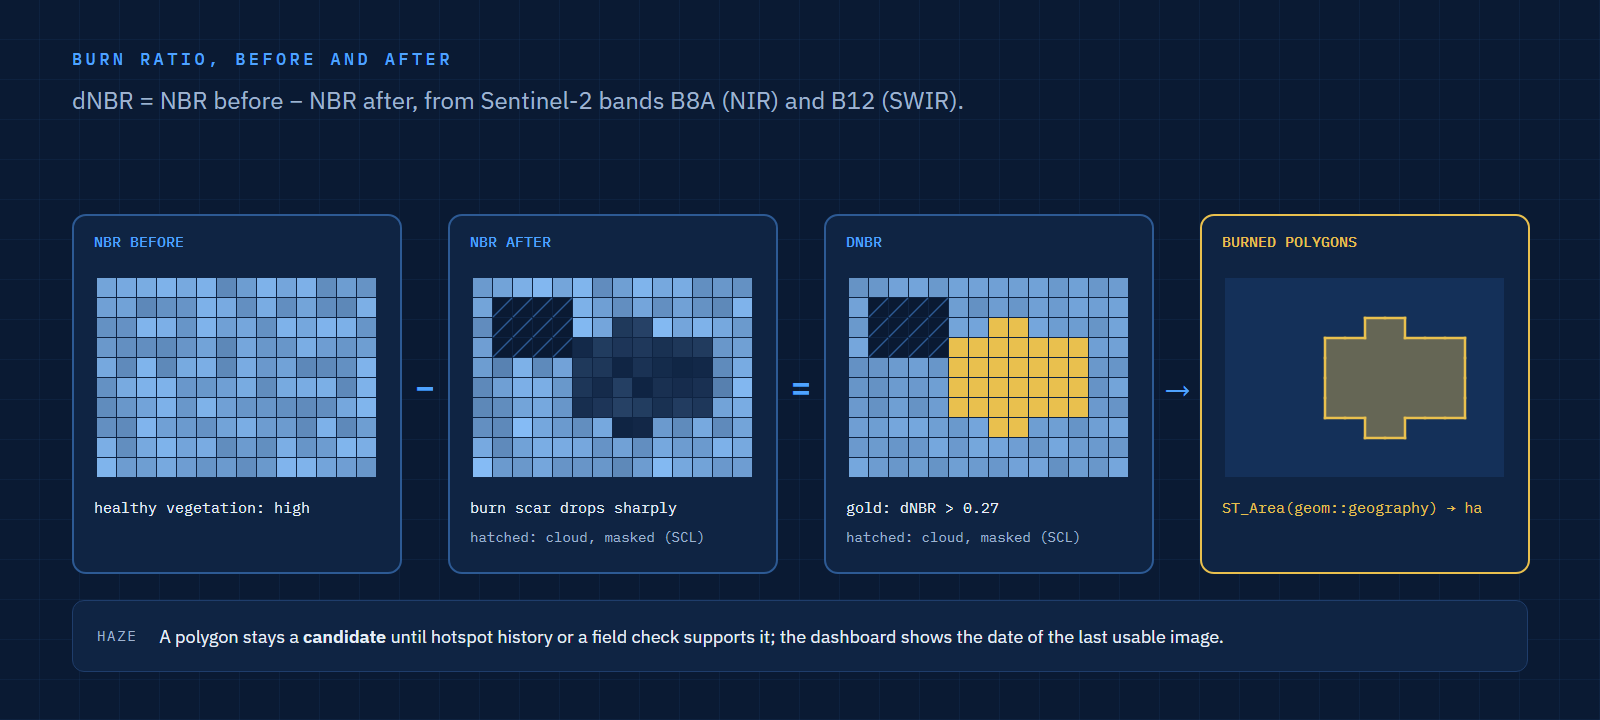 Buka ukuran penuh
Asap adalah keterbatasan yang harus diakui. Di minggu-minggu terburuk, citra optik bisa tidak berguna sama sekali. Desain ini memperlakukan poligon area terbakar sebagai kandidat sampai didukung riwayat titik panas atau cek lapangan, dan dashboard menampilkan kapan citra terakhir yang bisa dipakai diambil.
Bagaimana sistem ini diamankan, dipantau, dan dipelihara?
Dengan layanan AWS terkelola dan beberapa aturan yang lebih penting daripada tool-nya.
| Aspek | Desain |
|---|---|
| Akses | Amazon Cognito untuk pengguna web dan dashboard; peran untuk operasi, lapangan, pimpinan, dan analis |
| Enkripsi | S3 dan RDS terenkripsi KMS; TLS di semua jalur |
| Audit | CloudTrail untuk infrastruktur; tabel riwayat status yang hanya bisa ditambah untuk setiap tugas dan poligon |
| Monitoring | Alarm CloudWatch untuk run yang gagal; dashboard menampilkan waktu penarikan data terakhir yang berhasil |
| Backup dan pemulihan | Backup otomatis dan snapshot RDS; infrastruktur ditulis sebagai kode supaya stack bisa dibangun ulang |
| Retensi | Lifecycle rule S3 menghapus citra hasil potong setelah masa retensinya; riwayat vektor tetap disimpan |
Aturan monitoring yang paling saya pegang: pipeline yang berhenti harus berisik. Peta kosong setelah penarikan data gagal terlihat persis seperti hari yang aman.
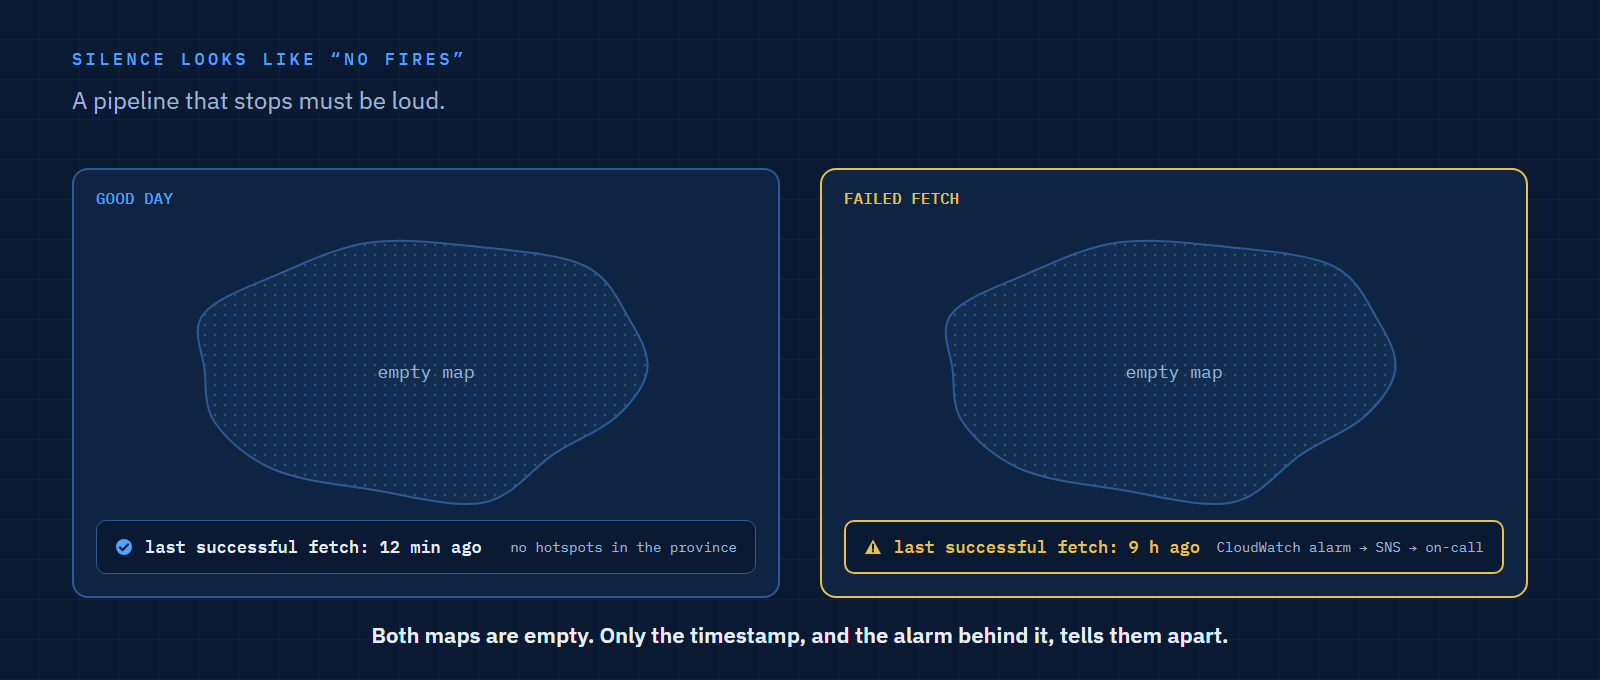 Buka ukuran penuh
Apa yang sengaja tidak saya masukkan?
Empat hal yang akan membuat versi pertama lebih sulit diwujudkan tanpa membuatnya lebih berguna untuk saat ini.
| Tidak dimasukkan | Alasannya | Kapan ditambahkan |
|---|---|---|
| Data geostasioner (Himawari) | Peringatan dalam hitungan menit menambah kompleksitas; FIRMS tiap jam cukup untuk versi pertama | Ketika tim lapangan bisa bergerak lebih cepat daripada datangnya peringatan |
| Radar Sentinel-1 | Preprocessing SAR adalah proyek tersendiri | Ketika asap menutup pemetaan optik sepanjang musim |
| Deep learning | Belum ada label lokal yang tervalidasi; aturan bisa dijelaskan sejak hari pertama | Setelah satu musim cluster yang dicek lapangan menyediakan data latih |
| Menautkan api ke izin lahan | Sensitif secara hukum, dan data izin tidak selalu publik | Hanya dengan mandat dan data yang otoritatif |
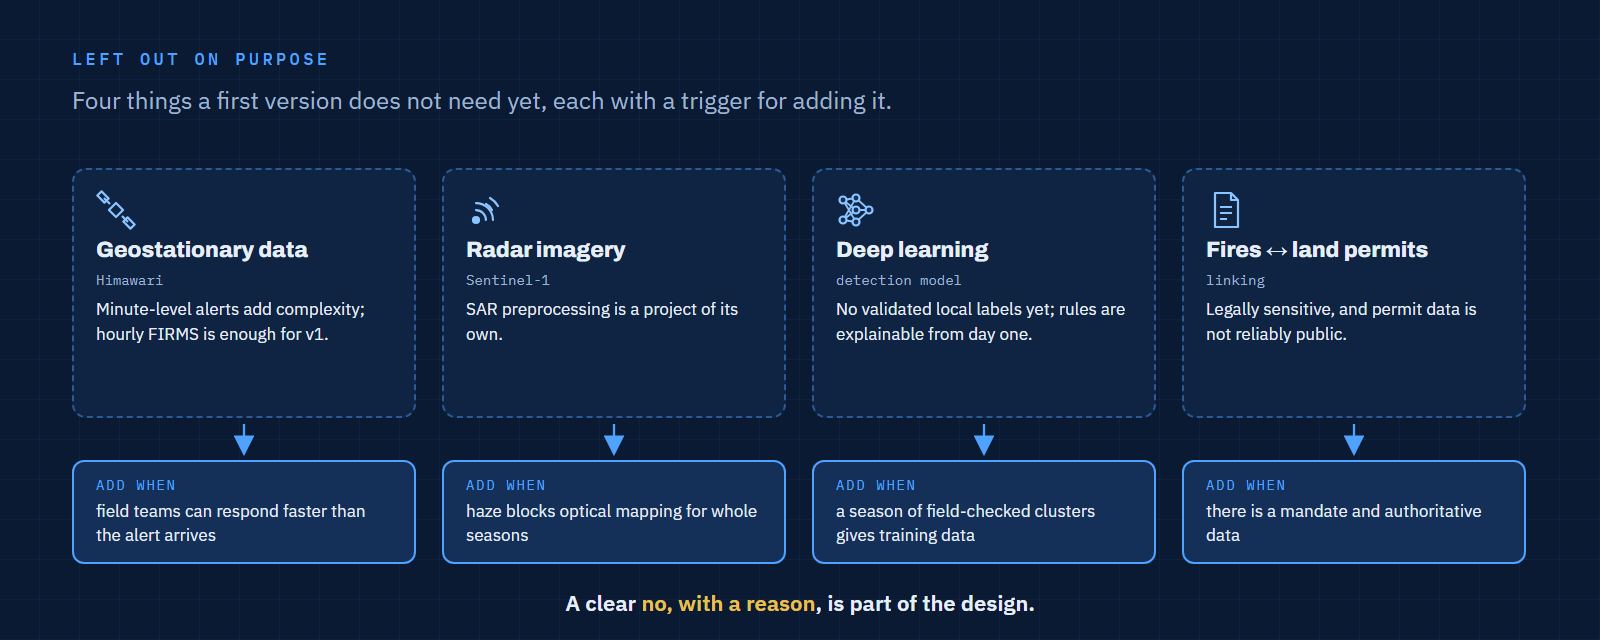 Buka ukuran penuh
Kebiasaan mendokumentasikan "tidak" ini saya ceritakan lebih jauh di Mendokumentasikan yang Tidak Saya Bangun.
FAQ
Bolehkah data Copernicus Sentinel dipakai di sistem pemerintah?
Boleh. Akses ke data Sentinel gratis, penuh, dan terbuka, termasuk untuk penggunaan operasional dan komersial. Produk turunannya sebaiknya mencantumkan sumber, misalnya "Contains modified Copernicus Sentinel data".
Kenapa tidak mengandalkan titik panas saja?
Titik panas hanya memberi tahu di mana suhu tinggi saat satelit melintas. Ia tidak memberi luas area yang terbakar, dan bisa melewatkan api di bawah asap tebal atau di antara dua lintasan. Pemetaan area terbakar mengisi celah itu setelahnya.
Kenapa PostGIS, bukan data warehouse?
Beban kerjanya operasional: penulisan kecil yang sering, spatial join dan clustering, serta analis yang mengedit di QGIS. Itu yang menjadi kekuatan PostgreSQL dengan PostGIS. Data warehouse baru berguna nanti untuk analisis bertahun-tahun.
Apakah desain ini hanya untuk Kalimantan Tengah?
Tidak. Dengan mengganti poligon provinsi, peta gambut, dan zona UTM, desain ini bisa dipakai untuk Riau, Sumatera Selatan, atau wilayah rawan kebakaran lainnya.
Referensi
- Fire Information for Resource Management System (FIRMS), NASA Earthdata
- Sentinel-2 Cloud-Optimized GeoTIFFs, Registry of Open Data on AWS
- Step by step: Burn Severity with Python and optical data (Sentinel-2), UN-SPIDER
- Indonesia's Mega Rice Project and the peatland food crisis, Mongabay, 2020
- ST_ClusterDBSCAN, dokumentasi PostGIS
- QFieldCloud, OPENGIS.ch
- Kenapa Kita Perlu Belajar Berpikir dengan Kerangka Arsitektur di Era AI, di situs ini
Terakhir diperbarui: 3 November 2026.